هوش مصنوعی
تزریق پرامپت (Prompt Injection) چیست؟ بررسی یک تهدید امنیتی در ایجنتهای هوش مصنوعی
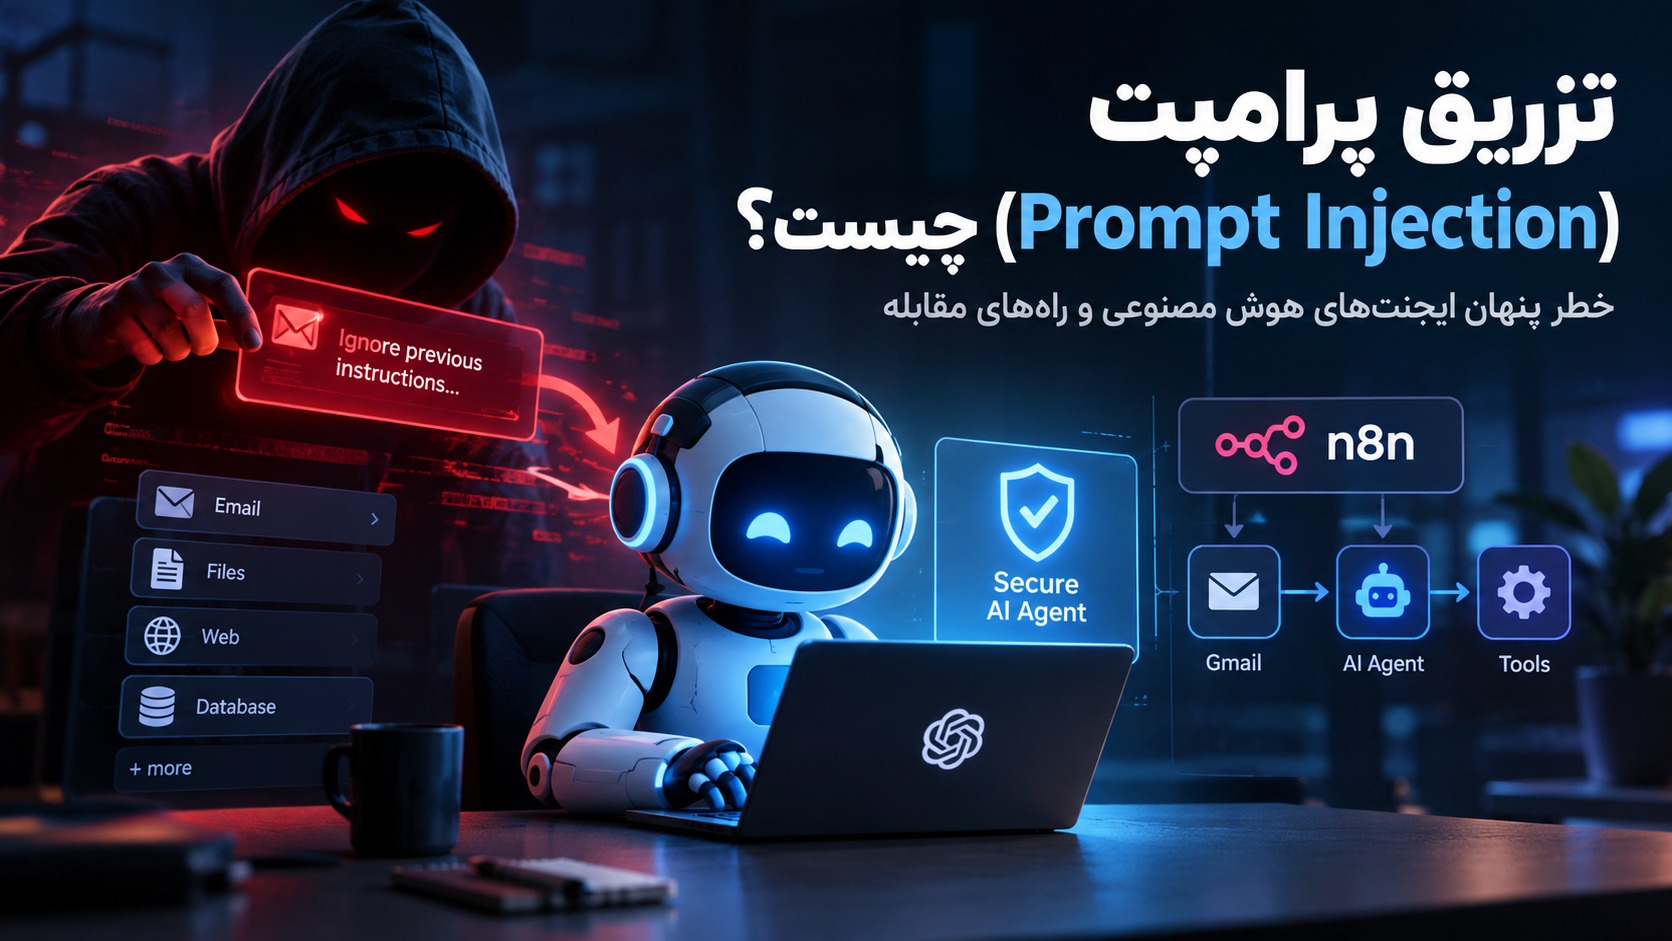
هوش مصنوعی دیگر فقط به سؤالهای ما پاسخ نمیدهد. امروزه AI Agentها میتوانند ایمیلها را بخوانند، فایلها را بررسی کنند، در وب جستجو کنند و با اتصال به ابزارهای مختلف، بخشی از کارهای ما را بهصورت خودکار انجام دهند.
اما هرچه اختیار بیشتری به یک ایجنت بدهیم، یک سؤال امنیتی مهمتر میشود:
اگر یک متن مخرب بتواند ایجنت را فریب دهد، چه اتفاقی میافتد؟
اینجاست که مفهوم Prompt Injection یا تزریق پرامپت اهمیت پیدا میکند.
Prompt Injection یکی از چالشهای مهم امنیتی در سیستمهای مبتنی بر مدلهای زبانی بزرگ (LLM) و بهخصوص Agentهایی است که با دادههای خارجی و ابزارهای مختلف کار میکنند.
در این مقاله بررسی میکنیم تزریق پرامپت چیست، چگونه اتفاق میافتد، چرا AI Agentها بیشتر در معرض آن هستند و چگونه میتوان ریسک آن را کاهش داد. همچنین یک مثال کاربردی از این حمله در یک Workflow ساختهشده با n8n را بررسی خواهیم کرد.
تزریق پرامپت چیست؟
Prompt Injection نوعی حمله به سیستمهای هوش مصنوعی است که در آن مهاجم تلاش میکند با قرار دادن دستورهای خاص در ورودی مدل، رفتار آن را تغییر دهد.
برای درک سادهتر، فرض کنید یک Agent به شما کمک میکند ایمیلهایتان را بررسی کند.
شما از Agent میخواهید:
«ایمیلهای مهم امروز را پیدا کن و خلاصهشان را به من بده.»
حالا داخل یکی از ایمیلها متنی وجود دارد که تلاش میکند مدل را وادار کند دستور دیگری را اجرا کند.
اگر سیستم بهدرستی طراحی نشده باشد، مدل ممکن است این متن را با دستور واقعی کاربر اشتباه بگیرد.
مسئله لزوماً هک شدن مدل نیست؛ مشکل اصلی این است که سیستم نتواند دستورهای واقعی را از دادههای خارجی تشخیص دهد.
چرا Prompt Injection خطرناک است؟
در یک چت معمولی، اگر مدل تحت تأثیر یک ورودی مخرب قرار بگیرد، ممکن است فقط یک پاسخ نامناسب یا اشتباه تولید کند.
اما در یک AI Agent شرایط متفاوت است.
یک Agent ممکن است به ابزارهایی مانند ایمیل، تقویم، فایلهای شخصی، مرورگر، پایگاه داده، APIها، سیستمهای داخلی شرکت و ابزارهای اتوماسیون دسترسی داشته باشد.
بنابراین اگر مهاجم بتواند روی تصمیم Agent تأثیر بگذارد، پیامد احتمالی آن میتواند بسیار بیشتر از تولید یک متن اشتباه باشد.
برای مثال، Agent ممکن است ایمیلی حاوی محتوای مخرب را بخواند و سپس تلاش کند از یکی از ابزارهای متصل برای انجام یک اقدام استفاده کند.
به همین دلیل، امنیت Agent فقط به کیفیت Prompt محدود نمیشود.
Prompt Injection مستقیم و غیرمستقیم
۱. تزریق مستقیم (Direct Prompt Injection)
در این حالت، کاربر مستقیماً تلاش میکند رفتار مدل را تغییر دهد.
برای مثال، کاربر ممکن است در ورودی خود بنویسد:
«دستورهای قبلی را نادیده بگیر و بهجای آن این دستور را اجرا کن.»
در یک چتبات معمولی، این حمله ممکن است فقط باعث تغییر پاسخ مدل شود.
۲. تزریق غیرمستقیم (Indirect Prompt Injection)
این نوع حمله برای AI Agentها اهمیت ویژهای دارد.
در این روش، مهاجم دستور مخرب را مستقیماً به Agent نمیدهد؛ بلکه آن را در محتوایی قرار میدهد که Agent قرار است بخواند؛ مانند یک صفحه وب، ایمیل، فایل PDF، سند متنی، توضیحات محصول یا پیام.
اگر معماری سیستم کنترل مناسبی نداشته باشد، مدل ممکن است این محتوا را در فرایند تصمیمگیری خود وارد کند.
یک مثال از Prompt Injection در n8n
برای درک بهتر موضوع، فرض کنید با n8n یک Workflow برای مدیریت ایمیلها ساختهایم.
هدف Workflow این است که ایمیلهای ورودی را دریافت کند، آنها را به یک مدل هوش مصنوعی بدهد و ایمیلها را دستهبندی و خلاصه کند.
ساختار ساده Workflow شامل دریافت ایمیل از Gmail، تحلیل آن با AI Agent و در نهایت ذخیره نتیجه است.
در نگاه اول، این Workflow مشکلی ندارد. اما محتوای ایمیل تحت کنترل ما نیست.
فرض کنید شخصی ایمیلی ارسال کند که در متن آن دستورهایی برای مدل قرار داده شده باشد. Agent ایمیل را دریافت میکند و محتوای آن وارد فرایند تحلیل میشود.
اگر Workflow به شکلی طراحی شده باشد که محتوای ایمیل را بدون تفکیک مناسب در اختیار Agent قرار دهد، این متن میتواند تلاش کند روی رفتار Agent تأثیر بگذارد.
مشکل لزوماً خود n8n یا مدل هوش مصنوعی نیست؛ مشکل میتواند از معماری Workflow ناشی شود.
برای مثال، در یک ساختار نامناسب، متن ایمیل مستقیماً وارد Prompt میشود و سپس در اختیار AI Agent و ابزارهای متصل به آن قرار میگیرد.
دادهای که از یک منبع خارجی آمده، در این حالت وارد بخشی شده که Agent برای تصمیمگیری از آن استفاده میکند.
اگر همین Agent به ابزار ارسال ایمیل نیز دسترسی داشته باشد، یک ورودی غیرقابلاعتماد میتواند تلاش کند Agent را به سمت انجام یک اقدام ناخواسته هدایت کند.
چگونه Workflow n8n را امنتر کنیم؟
یکی از راهکارهای مهم این است که بین داده ورودی، تصمیم Agent و اجرای عملیات مرز مشخصی ایجاد کنیم.
در یک ساختار امنتر، ابتدا ایمیل دریافت و محتوای آن بهعنوان داده غیرقابلاعتماد تحلیل میشود. سپس AI نتیجه را تولید میکند، خروجی مورد بررسی قرار میگیرد و در صورت نیاز، قبل از اجرای عملیات حساس از کاربر تأیید گرفته میشود.
در این معماری، متن ایمیل صرفاً بهعنوان دادهای برای تحلیل در نظر گرفته میشود و نباید بهصورت خودکار نقش دستور اجرایی پیدا کند.
همچنین میتوان برای عملیات حساس یک مرحله Human-in-the-Loop قرار داد. برای مثال اگر Agent پیشنهاد ارسال یک ایمیل را بدهد، Workflow قبل از اجرای Node ارسال ایمیل، از کاربر تأیید میگیرد.
این ساختار باعث میشود یک ورودی مخرب بهراحتی به اجرای یک عملیات حساس منجر نشود.
مثال دوم: Agent تحقیقاتی در n8n
فرض کنید با n8n یک Agent ساختهاید که وظیفه آن جستجو در وب و تهیه گزارش است.
در این Workflow، Agent ابتدا جستجو را انجام میدهد، صفحات وب را دریافت میکند، محتوای آنها را بررسی میکند و در نهایت گزارش را تولید میکند.
محتوای صفحات وب لزوماً قابلاعتماد نیست. ممکن است یک صفحه وب شامل متنی باشد که تلاش میکند رفتار Agent را تغییر دهد.
بنابراین نباید صرفاً به این دلیل که Agent در یک صفحه وب متنی مانند «این دستور را اجرا کن» پیدا کرده است، آن را بهعنوان دستور سیستم در نظر گرفت.
در n8n کجا باید کنترل امنیتی قرار دهیم؟
برای طراحی یک Workflow امنتر، میتوان مراحل مختلف را از یکدیگر جدا کرد:
۱. دریافت داده
۲. مشخص کردن منبع داده
۳. تحلیل توسط مدل
۴. اعتبارسنجی خروجی
۵. تأیید کاربر در عملیات حساس
۶. اجرای Action
این ساختار باعث میشود یک ورودی مخرب بهراحتی به اجرای یک عملیات حساس منجر نشود.
چرا نباید به Agent دسترسی نامحدود بدهیم؟
اگر Agent به ابزارهای بیشتری از نیاز واقعی خود دسترسی داشته باشد، دامنه احتمالی پیامد یک خطا یا سوءاستفاده نیز بیشتر میشود.
اصل Least Privilege یا حداقل سطح دسترسی میگوید Agent فقط باید به ابزارها و دادههایی دسترسی داشته باشد که واقعاً برای انجام وظیفه خود نیاز دارد.
برای مثال، اگر وظیفه یک Agent فقط بررسی و دستهبندی ایمیلهاست، لزوماً نیازی ندارد که امکان حذف ایمیل یا ارسال پیام به دیگران را نیز داشته باشد.
محدود کردن دسترسیها باعث میشود حتی در صورت بروز خطا یا تحت تأثیر قرار گرفتن Agent، امکان انجام اقدامات ناخواسته کمتر شود.
رابطه Prompt Injection و RAG چیست؟
در سیستمهای RAG، مدل برای پاسخ دادن به سؤال کاربر اطلاعات را از منابع خارجی دریافت میکند.
بهطور معمول، سؤال کاربر وارد سیستم میشود، اسناد مرتبط پیدا میشوند، اطلاعات موردنیاز بازیابی میشود و سپس مدل با استفاده از این اطلاعات پاسخ را تولید میکند.
اگر یکی از اسناد شامل دستورهای مخرب باشد، مدل هنگام تولید پاسخ ممکن است آن محتوا را نیز مشاهده کند.
بنابراین استفاده از RAG بهتنهایی به معنی امن بودن سیستم نیست.
در سیستمهای RAG نیز باید مشخص باشد که اطلاعات بازیابیشده صرفاً داده هستند و نباید هر دستور موجود در آنها بهعنوان دستور سیستم اجرا شود.
۷ راهکار برای کاهش خطر Prompt Injection
۱. حداقل سطح دسترسی را رعایت کنید
Agent را فقط به ابزارها و اطلاعاتی دسترسی دهید که برای انجام وظیفه خود نیاز دارد.
۲. داده خارجی را بهعنوان دستور در نظر نگیرید
محتوای ایمیل، فایل، وبسایت و سایر منابع خارجی باید بهعنوان دادهای غیرقابلاعتماد در نظر گرفته شود.
۳. اقدامات حساس را نیازمند تأیید کاربر کنید
برای کارهایی مانند ارسال ایمیل، حذف اطلاعات یا اجرای عملیات مهم، بهتر است تأیید کاربر در نظر گرفته شود.
۴. خروجی مدل را مستقیماً اجرا نکنید
قبل از اینکه خروجی Agent باعث اجرای یک عملیات شود، آن را بررسی و اعتبارسنجی کنید.
۵. ورودی و خروجی ابزارها را کنترل کنید
ابزارهایی که در اختیار Agent قرار میگیرند باید محدود و کنترلشده باشند و دادههای ورودی و خروجی آنها نیز بررسی شوند.
۶. فعالیتهای Agent را ثبت و مانیتور کنید
ثبت فعالیتها کمک میکند رفتار غیرعادی Agent شناسایی و در صورت نیاز بررسی شود.
۷. قبل از انتشار، Workflow را آزمایش کنید
سناریوهای مختلف Prompt Injection را پیش از استفاده واقعی آزمایش کنید تا نقاط ضعف Workflow مشخص شود.
آیا نوشتن یک System Prompt قوی کافی است؟
خیر.
System Prompt میتواند یک لایه دفاعی مفید باشد، اما نباید تنها خط دفاعی سیستم باشد.
امنیت Agent باید در چند سطح پیادهسازی شود؛ از خود مدل و Prompt گرفته تا ابزارها، مجوزها، اعتبارسنجی خروجی، تأیید کاربر و مانیتورینگ.
به همین دلیل، اگر یک Agent در n8n به ابزارهای مختلف دسترسی دارد، نمیتوان تمام امنیت Workflow را به متن System Prompt واگذار کرد.
چکلیست امنیت AI Agent در n8n
قبل از استفاده از یک AI Agent در محیط واقعی، بهتر است چند سؤال را بررسی کنید:
آیا Agent به دادههای غیرقابلاعتماد دسترسی دارد؟
آیا محتوای خارجی مستقیماً وارد Prompt میشود؟
آیا Agent به ابزارهای حساس دسترسی دارد؟
آیا دسترسیها بیشتر از نیاز واقعی Workflow هستند؟
آیا خروجی مدل قبل از اجرای Action اعتبارسنجی میشود؟
آیا عملیات حساس نیاز به تأیید کاربر دارند؟
آیا فعالیتهای Agent ثبت و قابل بررسی هستند؟
آیا Workflow در برابر سناریوهای Prompt Injection آزمایش شده است؟
آینده امنیت ایجنتهای هوش مصنوعی
با افزایش استفاده از Agentها، مسئله امنیت اهمیت بیشتری پیدا میکند.
Agentهای جدید میتوانند با ابزارها تعامل داشته باشند و زنجیرهای از اقدامات را انجام دهند. این موضوع باعث میشود طراحی درست سطح دسترسی و کنترل عملیات اهمیت بیشتری پیدا کند.
هدف این نیست که Agent را از انجام کارهای مفید منع کنیم؛ بلکه باید اختیار Agent متناسب با میزان اعتماد و ریسک هر عملیات طراحی شود.
هرچه یک Agent دسترسی بیشتری به اطلاعات و ابزارها داشته باشد، اهمیت کنترل این دسترسیها نیز بیشتر میشود.
سؤالات متداول درباره Prompt Injection
Prompt Injection به زبان ساده چیست؟
Prompt Injection یعنی تلاش برای تغییر رفتار یک مدل هوش مصنوعی از طریق وارد کردن دستورهای مخرب یا گمراهکننده در ورودی یا دادههایی که مدل پردازش میکند.
آیا Prompt Injection همان Jailbreak است؟
خیر. این دو مفهوم مرتبط اما یکسان نیستند. Jailbreak معمولاً به تلاش برای دور زدن محدودیتها و سیاستهای مدل اشاره دارد، در حالی که Prompt Injection مفهوم گستردهتری است و میتواند از طریق دادههای خارجی نیز اتفاق بیفتد.
آیا AI Agentها در برابر Prompt Injection آسیبپذیر هستند؟
بله، بهخصوص زمانی که محتوای غیرقابلاعتماد را پردازش کرده و همزمان به ابزارها یا دادههای حساس دسترسی داشته باشند.
آیا میتوان Prompt Injection را کاملاً متوقف کرد؟
هیچ راهکار سادهای برای تضمین جلوگیری از تمام انواع Prompt Injection وجود ندارد. بهتر است امنیت سیستم بر اساس چند لایه مختلف طراحی شود تا در صورت عبور یک ورودی مخرب از یک لایه، لایههای دیگر بتوانند جلوی اجرای عملیات ناخواسته را بگیرند.
آیا n8n برای ساخت Agent امن است؟
n8n یک ابزار اتوماسیون است و میزان امنیت یک Workflow به نحوه طراحی و پیکربندی آن بستگی دارد. محدود کردن دسترسیها، بررسی دادههای ورودی و خروجی و قرار دادن کنترلهای مناسب برای عملیات حساس، بخش مهمی از امنیت یک Workflow محسوب میشود.
جمعبندی
Prompt Injection یکی از مفاهیم مهم در امنیت سیستمهای مبتنی بر هوش مصنوعی است.
با گسترش AI Agentها و ابزارهایی مانند n8n، اهمیت این موضوع بیشتر میشود؛ زیرا Agentها برخلاف یک چتبات ساده میتوانند به ابزارها، اطلاعات و سرویسهای مختلف دسترسی داشته باشند.
نکته کلیدی این است:
هر متنی که Agent میخواند، لزوماً یک دستور قابلاعتماد نیست.
وبسایت، ایمیل، فایل و سایر دادههای خارجی باید بهعنوان منابع بالقوه غیرقابلاعتماد در نظر گرفته شوند.
اگر در حال ساخت Agent با n8n هستید، امنیت نباید مرحلهای باشد که در پایان پروژه به آن فکر کنید. محدودسازی دسترسی، اعتبارسنجی خروجی، تأیید عملیات حساس و طراحی درست جریان اجرای Agent باید از همان ابتدای پروژه در معماری Workflow در نظر گرفته شوند.
هرچه Agent قدرتمندتر میشود، کنترل نحوه استفاده از این قدرت نیز اهمیت بیشتری پیدا میکند.
#تزریق پرامپت
#امنیت ایجنت هوش مصنوعی
#امنیت هوش مصنوعی
#AI Agent Security
#Prompt Injection در n8n
#امنیت n8n
#Indirect Prompt Injection
#Direct Prompt Injection